MOSS-Image-SFT 是 OpenMOSS 的MOSS-Image系列中的一个监督式微调文本到图像模型 ,源自 MOSS-Image-Base。它使用相同的架构和推理流程,支持自然语言提示、标签序列和 JSON 布局,用于控制文本位置和对象排列。
亮点:
1. 长篇中文和英文渲染,是最有说服力的亮点
过去很多模型能写标题,但正文一长就容易漏字、乱码、重复。MOSS-Image 专门强化了这类能力。
作者新建的 LongLongTextBench(LLTB) 包含 240 个中英文任务,平均每个目标约 1,340 个字符,比原 LongTextBench 的平均文本长度高约 11 倍。
报告中的结果:
| 模型 | LLTB 文本覆盖率 |
|---|---|
| Qwen Image 2512 | 64.9% |
| Qwen Image 3.0 Pro | 94.3% |
| MOSS-Image | 96.3% |
| Nano Banana Pro | 96.6% |
| GPT Image 2 | 99.0% |
它在作者列出的开放权重模型中领先,最长中文组也达到 92.4%。
但这里必须读准指标:覆盖率基于 OCR 识别后的词/字符匹配,不检查顺序,也不直接惩罚多余文本。 所以 96.3% 不能理解成“生成一页文字,有 96.3% 的概率完全无错”。
它说明模型能较完整地呈现长文本,正式发布的海报仍需校对。
- 布局控制从模糊描述,推进到结构化位置指令
模型接受自然语言,也接受 JSON Layout。你可以明确指定:
- 标题写什么,放在哪里;
- 正文块的范围和描述;
- 人物、产品、插图的位置;
- 整体画布与视觉风格。
这意味着可以先规划“标题在顶部、产品居中、卖点在右侧”,再交给模型生成,减少反复抽图。
实现上的亮点是:布局 JSON 和普通描述共用文本条件通道。 不需要为了这种布局输入,再额外挂一个专用 ControlNet。
在现有的 7Bench 布局评测中,作者报告:
指标 MOSS-Image 同表中其他模型最高值
检测到的目标,其平均位置重合度 0.88 0.44
Layout AUC 0.70 0.20
差距相当明显。不过第一项排除了未检测到的目标;把所有目标纳入,MOSS-Image 的平均重合度是 0.679。这仍然支持它有较强的位置控制,但不等于像排版软件一样精确执行每个框。
官方也将 Layout 标为实验性功能
最值得试的是中文知识卡、课程配图、带正文的封面和有明确版式的海报。
项目地址:https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT
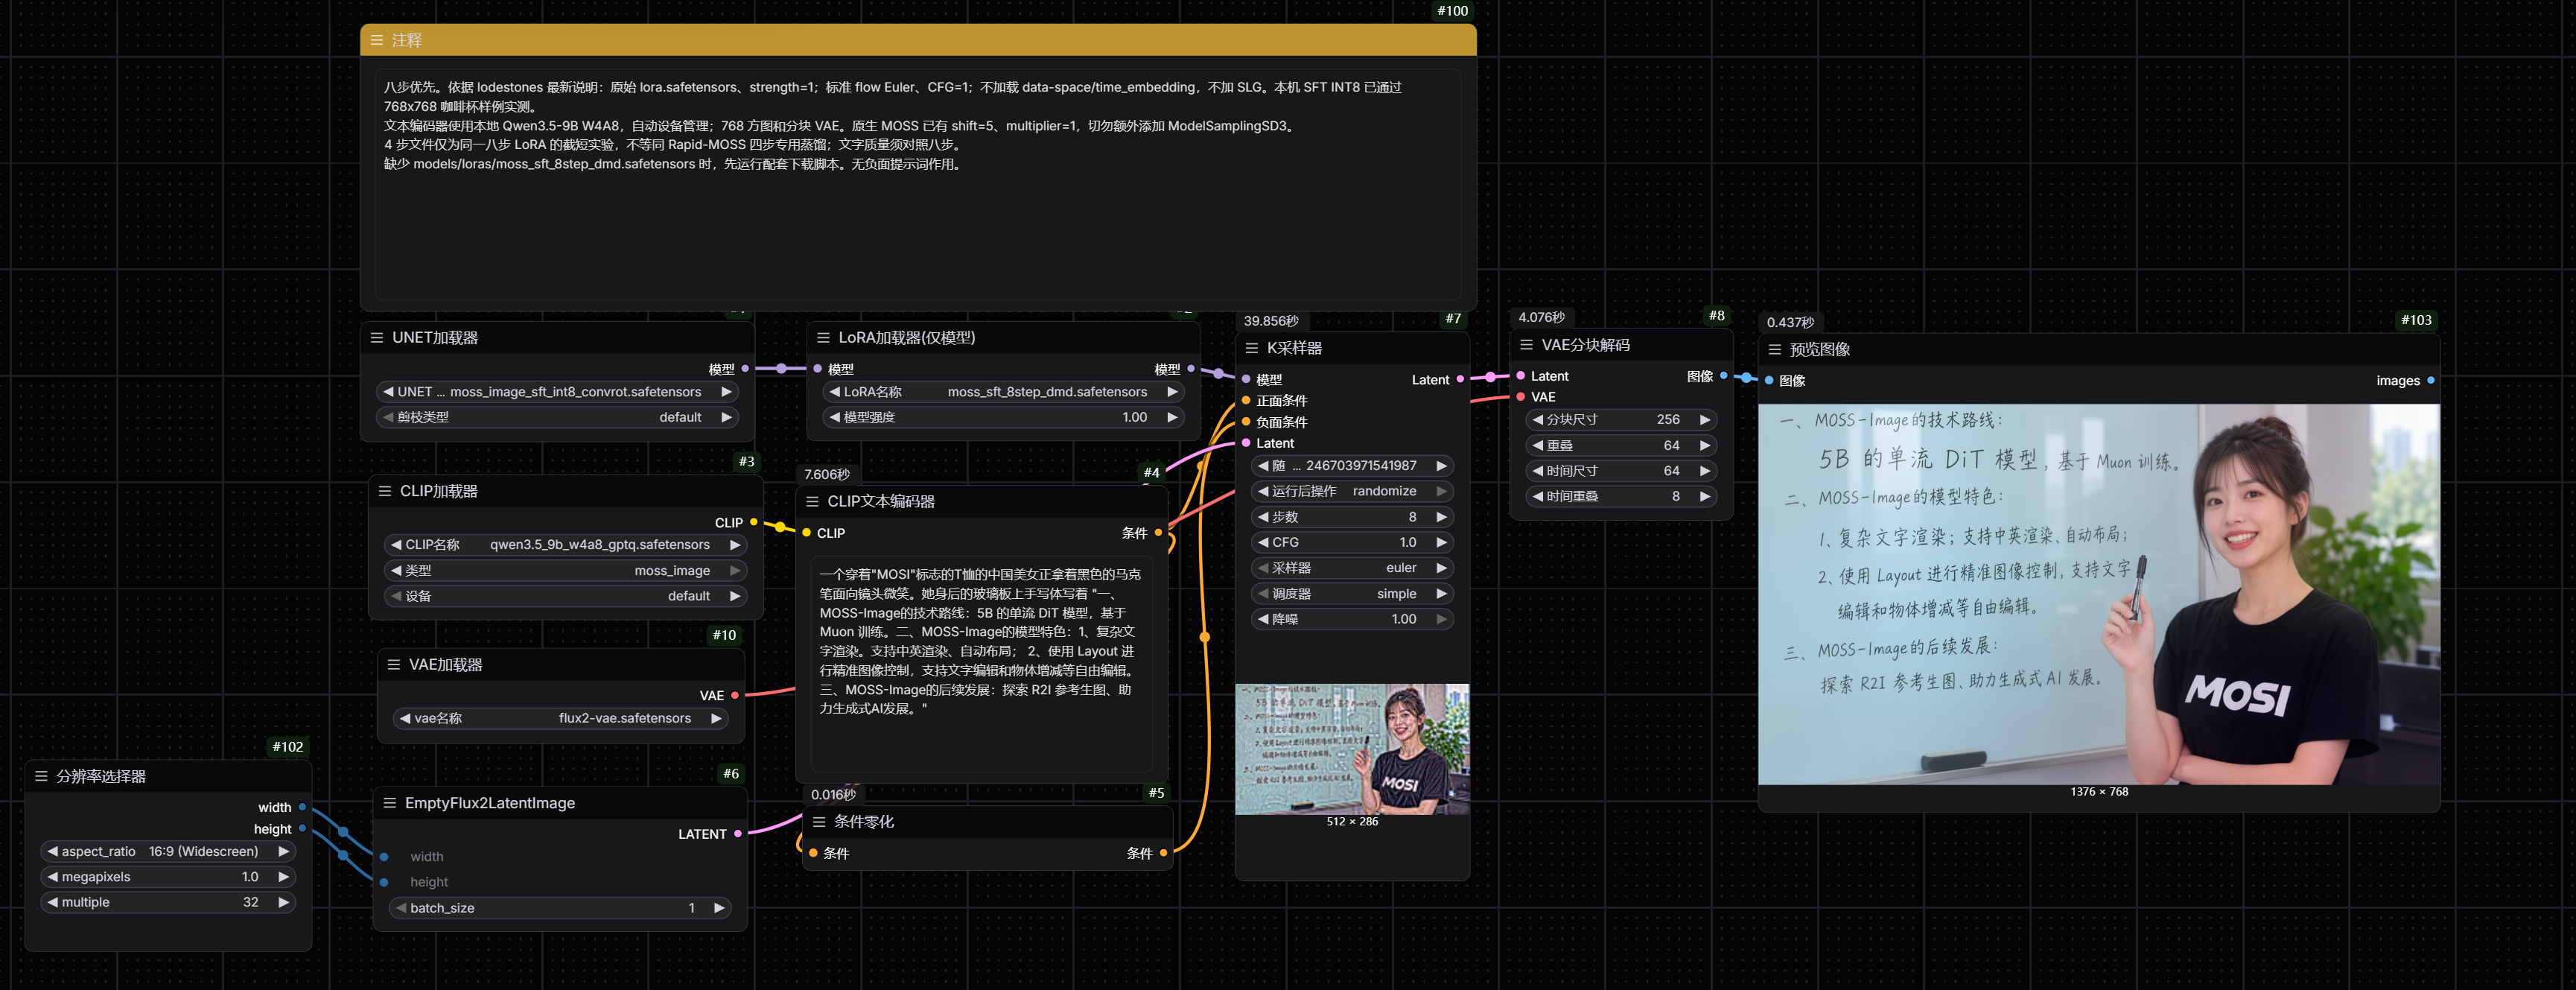
comfyUI中使用:8步加速LORA生成,工作流如下:
模型、工作流下载:
主题授权提示:请在后台主题设置-主题授权-激活主题的正版授权,授权购买:RiTheme官网
声明:本站所有文章,如无特殊说明或标注,均为本站原创发布。任何个人或组织,在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。

评论(0)